Por dentro de las integraciones de plataformas de casino: La ingeniería que mantiene a los operadores en línea
Actualizado 2 oct 2026•Publicado 2 oct 2026
Puntos clave
- Cada lanzamiento de un juego esconde toda una cadena: la plataforma autentica al jugador, protege la sesión e intercambia validaciones con el proveedor —todo ello en cuestión de segundos—.
- Las plataformas turnkey aportan años de ingeniería: los operadores heredan la arquitectura, la seguridad, el cumplimiento normativo y las integraciones con bastante más de un centenar de proveedores, cada uno con su propia API.
- Las API deficientes causan daños reales: las integraciones débiles exponen vulnerabilidades de seguridad, desconectan sesiones, desincronizan saldos y minan la confianza de los jugadores.
- La arquitectura aísla los fallos de los proveedores: una plataforma bien diseñada actúa como capa de protección y contiene el problema de un proveedor antes de que se extienda por todo el sistema.
- La telemetría detecta los problemas en segundos: las llamadas que superan de forma sistemática los ~200 milisegundos señalan que el servicio de un proveedor se está degradando, y la plataforma puede desactivarlo automáticamente.
- La certificación es solo el principio: las baterías de pruebas automatizadas continuas detectan los cambios no anunciados de los proveedores antes de que se conviertan en incidencias operativas.
- Pregunte por los datos en tiempo real y por la posibilidad de reproducirlos: estas dos capacidades, que a menudo se pasan por alto, revelan si una plataforma puede operarse de verdad —o si es una caja negra—.
Cada vez que un jugador lanza un juego de casino, se produce en segundo plano una compleja secuencia de eventos. Varios sistemas autentican al jugador, establecen sesiones seguras, intercambian datos con proveedores de juegos externos y mantienen sincronizados los saldos, las apuestas y las ganancias. Y todo ello sucede en cuestión de segundos.
Para los operadores, gran parte de esta ingeniería permanece invisible hasta que algo falla. Un proveedor lento, una API inestable o una caída inesperada, por ejemplo, bastan para que surja un problema comercial que puede afectar rápidamente a la confianza de los jugadores y a los ingresos.
Construir la arquitectura que mantiene esos riesgos bajo control exige años de experiencia en ingeniería. Desde integraciones estables y sistemas de failover hasta pruebas rigurosas, gran parte del valor de una plataforma reside en evitar que los operadores sufran problemas.
Hablamos con Ioannis Loukeris, del equipo de desarrollo de Agreegain, sobre la disciplina de ingeniería que hay detrás de las plataformas de casino modernas, la importancia de contar con integraciones resilientes y lo que los operadores deben saber antes de elegir un socio tecnológico.
¿Qué ocurre realmente detrás de cada lanzamiento de un juego?
Desde la perspectiva del jugador, lanzar un juego de casino suele ser instantáneo. Sin embargo, entre bastidores, decenas de procesos técnicos trabajan de forma coordinada para autenticar a los usuarios, establecer conexiones seguras y sincronizar la información entre múltiples sistemas. Comprender esa complejidad oculta ayuda a explicar por qué resulta tan difícil replicar una ingeniería de plataformas con experiencia.
P: Para un operador que nunca ha visto lo que hay entre bastidores, ¿qué ocurre técnicamente cuando un jugador abre un juego de casino?
La mayoría de los jugadores hacen clic en «Jugar» y esperan que el juego cargue casi al instante. Sin embargo, detrás de ese simple clic se produce una secuencia de comunicaciones cuidadosamente orquestada entre la plataforma de casino y el proveedor del juego.
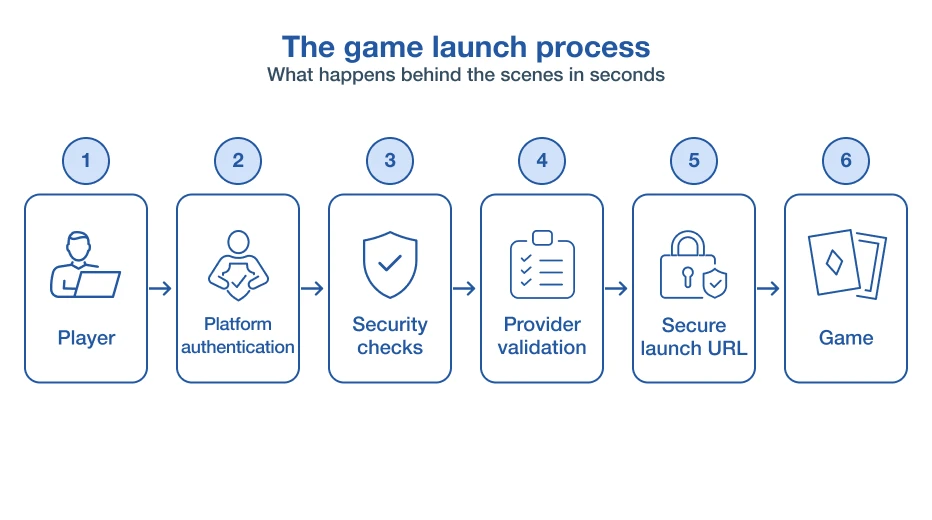
El proceso comienza cuando el front end solicita a la plataforma una URL de lanzamiento del juego. Antes de que esa solicitud llegue siquiera al proveedor, la plataforma autentica al jugador, realiza las comprobaciones de seguridad necesarias y establece una sesión segura. A continuación, el proveedor realiza su propia validación, confirma que todo está en orden y se comunica con la plataforma para preparar la sesión de juego. Solo cuando se completan estas comprobaciones, el proveedor genera una URL de lanzamiento segura y la devuelve a la plataforma, que a su vez la transmite al navegador del jugador para que el juego pueda cargarse por fin.
Aunque todo este intercambio suele durar solo unos segundos, cada paso tiene que funcionar a la perfección. El jugador espera una experiencia rápida y fluida, pero entre bastidores la plataforma verifica identidades, protege datos, sincroniza información y garantiza de forma continua una comunicación segura entre múltiples sistemas independientes. Si falla cualquier eslabón de esa cadena, es posible que el juego no se inicie correctamente.
Por eso, construir una plataforma de casino moderna va mucho más allá de conectar juegos de distintos proveedores. El reto de ingeniería consiste en hacer que un proceso extremadamente complejo parezca sencillo y, al mismo tiempo, garantizar que cada interacción sea segura, precisa y fiable, mucho antes de que el jugador realice su primera apuesta.
P: Cuando un operador elige una plataforma turnkey o un agregador, ¿qué trabajo de ingeniería hereda en realidad?
Una plataforma turnkey de calidad representa años de ingeniería, perfeccionamiento y experiencia operativa real. No es simplemente un conjunto de funcionalidades reunidas en una sola interfaz. Detrás hay toda la arquitectura, la seguridad, el cumplimiento normativo, las integraciones y el conocimiento operativo necesarios para sostener un negocio de iGaming moderno.
Esta tarea se ha vuelto aún más exigente a medida que ha evolucionado la regulación. Hoy en día, las plataformas deben operar en múltiples jurisdicciones, integrarse con una amplia variedad de servicios de terceros, proteger datos sensibles y mantener su fiabilidad ante una demanda continua. Construir todo eso desde cero requiere una inversión considerable de tiempo, conocimientos y recursos. Incluso una plataforma diseñada para un único operador en un solo mercado es un proyecto de gran envergadura.
El mismo principio se aplica a la agregación de juegos. En el mercado hay bastante más de un centenar de proveedores de juegos, cada uno con su propia API, sus propios requisitos técnicos y su propia forma de gestionar las sesiones de juego, las transacciones y las actualizaciones. Mantener esas integraciones al día y sincronizadas es, en sí mismo, un trabajo de ingeniería continuo.
Un agregador elimina gran parte de esa complejidad al ofrecer a los operadores una única integración estable. En lugar de mantener decenas de conexiones individuales con proveedores y adaptarse por su cuenta a cada cambio técnico, los operadores se integran una sola vez y dejan que el agregador se encargue del mantenimiento continuo entre bastidores. Esto permite a los operadores centrar sus propios recursos de desarrollo en las áreas que diferencian su negocio, en lugar de dedicarlos a mantener constantemente las integraciones con proveedores.
Cómo protege la buena ingeniería a los operadores frente al riesgo técnico
Los problemas técnicos no se quedan mucho tiempo en el terreno puramente técnico. Los proveedores lentos, las integraciones inestables o las API mal diseñadas acaban provocando sesiones interrumpidas, jugadores frustrados y pérdida de ingresos. Las siguientes preguntas analizan cómo una arquitectura de plataforma resiliente evita esos problemas antes de que afecten al negocio del operador.
P: A menudo se oye el término «API», pero ¿qué aspecto tiene en la práctica una integración mal diseñada?
Una API bien diseñada es algo que los jugadores nunca deberían notar. Cuando funciona correctamente, las sesiones de juego se inician sin problemas, los saldos se mantienen exactos, las apuestas se procesan correctamente y las ganancias se abonan sin demora. Los problemas solo se hacen evidentes cuando todo eso empieza a fallar.
Uno de los riesgos más graves es la seguridad. Como cualquier sistema que mueve dinero y gestiona datos sensibles de los jugadores, las API de los proveedores de juegos están expuestas constantemente a intentos de ataque. Si esas interfaces no se diseñan y mantienen con un alto nivel de exigencia, pueden introducir vulnerabilidades innecesarias que ponen en riesgo tanto a los operadores como a los jugadores.
La estabilidad es igual de importante. Una integración poco fiable puede provocar que las sesiones de juego se desconecten de forma inesperada, que se retrase la confirmación de apuestas o ganancias, o que los saldos queden desincronizados temporalmente. Incluso después de resolver el problema de fondo, el jugador sigue percibiendo incertidumbre. Si no puede ver de inmediato sus ganancias o completar una sesión como esperaba, su confianza en la plataforma empieza a disminuir.
La documentación también desempeña un papel más importante de lo que muchos creen. Las API mal documentadas o incoherentes obligan a los desarrolladores a crear soluciones alternativas solo para que distintos sistemas puedan comunicarse. Esas soluciones alternativas añaden una complejidad innecesaria y se convierten en puntos de fallo adicionales a medida que evolucionan las plataformas.
En definitiva, la calidad de una integración se mide por lo poco que la notan los jugadores. La mejor ingeniería es la que pasa desapercibida y permite que cada juego, cada transacción y cada actualización del saldo se produzcan de forma coherente, segura y sin interrupciones.
P: ¿Cómo evitan que los problemas técnicos de un proveedor se conviertan en un problema del operador?
El objetivo es garantizar que un problema que afecta a un proveedor siga siendo exactamente eso —un problema del proveedor— y no algo que altere toda la plataforma del operador.
Para lograrlo, todo empieza por la arquitectura de la plataforma. Una plataforma o un agregador bien diseñados actúan como una capa de protección entre el operador y los numerosos servicios de terceros de los que depende. En lugar de exponer directamente al operador a los distintos comportamientos y diferencias técnicas de cada proveedor, la plataforma estandariza esas interacciones mediante una interfaz coherente y supervisa de forma continua el rendimiento de cada proveedor.
Si ocurre algo inesperado, ya sea un error, un comportamiento inestable o que un proveedor deje de estar disponible, la plataforma debe ser capaz de aislar el problema antes de que se extienda. Esto significa evitar que un servicio que falla afecte a partes no relacionadas de la plataforma o cause una interrupción más amplia para los jugadores.
El mismo principio se aplica a la seguridad. Al controlar cómo circula la información entre el operador y los proveedores externos, la plataforma reduce la exposición innecesaria y ayuda a filtrar los problemas antes de que lleguen al resto del sistema.
En definitiva, la resiliencia no consiste en dar por hecho que nunca habrá problemas. En una plataforma conectada a decenas de proveedores externos, las incidencias ocasionales son inevitables. La buena ingeniería consiste en contenerlas con rapidez para que el resto de la plataforma siga funcionando con normalidad mientras se investiga y se resuelve el problema del servicio afectado.
P: A medida que los operadores siguen añadiendo proveedores y miles de juegos nuevos, ¿cómo consiguen que la plataforma mantenga un rendimiento constante?
La arquitectura del sistema es el factor más importante para la escalabilidad. Añadir más proveedores y juegos no consiste simplemente en aumentar la cantidad de contenido disponible para los jugadores. Cada nueva integración implica más comunicaciones, más procesamiento de datos y más interacciones entre sistemas que la plataforma debe gestionar de forma eficiente.
Una arquitectura bien diseñada utiliza tecnologías modernas y topologías cuidadosamente planificadas para escalar a medida que crece la demanda. Lo ideal es que el rendimiento aumente de forma predecible, casi lineal, a medida que se incorporan recursos adicionales, en lugar de volverse cada vez más difícil de gestionar.
También existe la idea errónea, bastante extendida, de que adoptar una arquitectura orientada a servicios o distribuida resuelve automáticamente la escalabilidad. En realidad, eso es solo una parte de la solución. La forma en que los servicios se comunican entre sí y las responsabilidades asignadas a cada uno son igual de importantes. Un mal diseño a ese nivel puede generar problemas innecesarios, por moderna que sea la tecnología subyacente.
En definitiva, toda plataforma llega a un punto en el que la base de datos se convierte en uno de los retos de ingeniería más importantes. A medida que se suman proveedores, jugadores y transacciones, mantener el rendimiento depende de decisiones de arquitectura bien meditadas en toda la plataforma, y no solo de añadir más hardware. Ahí es donde una ingeniería rigurosa resulta esencial para que los operadores puedan seguir ampliando su contenido sin comprometer la experiencia del jugador.
P: ¿Puede describir un reto de integración especialmente difícil que haya resuelto su equipo y qué habrían experimentado los operadores si no se hubiera resuelto?
Uno de los retos técnicos más exigentes a los que nos hemos enfrentado ha sido la enorme variedad de formas en que operan los distintos proveedores de juegos. Vistos desde fuera, puede parecer que todos ofrecen lo mismo: un catálogo de juegos de casino. Pero, entre bastidores, su lógica de funcionamiento, sus métodos de comunicación y sus requisitos técnicos pueden diferir considerablemente.
Nuestro objetivo era unificar todos esos enfoques distintos tras una única API coherente. Al principio, algunos proveedores eran tan diferentes que parecía casi imposible conseguirlo. Hizo falta una planificación cuidadosa, una investigación exhaustiva y mucho análisis para entender dónde estaban esas diferencias y cómo salvarlas sin comprometer la fiabilidad.
En algunos casos, también tuvimos que compensar problemas de las propias implementaciones de los proveedores y resolverlos dentro de nuestro sistema para que los operadores pudieran interactuar con todos los proveedores exactamente de la misma manera.
Si no hubiéramos resuelto esos retos, algunos proveedores sencillamente no se habrían podido ofrecer a través del agregador. Y, lo que es más importante, los operadores habrían tenido que lidiar con un comportamiento incoherente entre proveedores, con apuestas, ganancias y sesiones de juego gestionadas de forma distinta según el estudio que estuviera utilizando el jugador. Eso anularía en gran medida el sentido de utilizar un agregador.
El objetivo nunca fue simplemente conectar más proveedores. Se trataba de garantizar que, independientemente de quién hubiera desarrollado el juego, los operadores pudieran confiar en una integración única y coherente, con un comportamiento predecible en toda la plataforma.
Cómo mantener miles de integraciones funcionando de forma fiable
Desarrollar integraciones es solo una parte del reto. Lograr que cientos de conexiones con proveedores funcionen de forma fiable durante meses y años exige supervisión y pruebas continuas, además de disciplina operativa. Aquí es donde se genera gran parte del valor a largo plazo de una plataforma, aunque los operadores y los jugadores rara vez vean la ingeniería que hay detrás.
P: ¿Cómo reduce el riesgo técnico una única integración con un agregador frente a mantener decenas de integraciones directas con proveedores?
El valor de un agregador reside en ofrecer a los operadores una única API estable que no cambia, o que solo cambia de forma retrocompatible. Una vez implementada y validada esa integración, los operadores pueden seguir gestionando sus propios sistemas sin tener que adaptarse constantemente a los cambios que introduce cada proveedor de juegos.
Sin embargo, entre bastidores, esos proveedores siguen evolucionando. Incorporan nuevas funcionalidades, actualizan sus API, refuerzan la seguridad o, en ocasiones, incluso introducen cambios que requieren un esfuerzo de ingeniería considerable para darles soporte. En algunos casos, esos cambios ni siquiera son retrocompatibles.
En lugar de que cada operador tenga que supervisar, implementar y probar esos cambios por su cuenta, el agregador asume esa responsabilidad. Actualiza cada integración con los proveedores, mantiene la compatibilidad y garantiza que la plataforma siga ofreciendo a los operadores la misma interfaz estable con la que se integraron en un principio.
Para los operadores que mantienen conexiones directas, esa responsabilidad nunca desaparece. Cada relación con un proveedor se convierte en una integración más que supervisar, mantener y sincronizar a lo largo del tiempo. A medida que aumenta el número de proveedores, también crece el esfuerzo de ingeniería necesario solo para que todo siga funcionando de forma fiable.
En definitiva, el papel de un agregador no se limita a simplificar la integración inicial. Consiste en asumir el trabajo de ingeniería continuo que exige mantener decenas de conexiones con proveedores, de modo que los operadores puedan concentrar sus propios recursos de desarrollo en construir y mejorar su plataforma, en lugar de dedicarlos a mantener constantemente integraciones de terceros.
P: Cuando algo falla, ¿con qué rapidez puede la plataforma detectarlo y reaccionar antes de que afecte a los jugadores?
Gracias a la telemetría, podemos detectar posibles incidencias casi al instante. Supervisamos cada interacción con un proveedor, de modo que, si los tiempos de respuesta empiezan a aumentar, podemos identificar un comportamiento anómalo en cuestión de segundos. Por ejemplo, si las llamadas individuales superan de forma sistemática los 200 milisegundos aproximadamente, se pueden considerar sospechosas. Cuando se acumulan suficientes eventos de ese tipo, normalmente es posible confirmar que el servicio del proveedor se está degradando y que no se trata de un retraso puntual.
Una vez identificado el problema, la respuesta depende de las preferencias del operador. La plataforma puede aislar automáticamente al proveedor afectado: lo desactiva y retira sus juegos del lobby, lo que impide que nuevos jugadores entren en sesiones poco fiables.
Los jugadores que ya están dentro de una partida requieren, lógicamente, un tratamiento diferente. Si un proveedor deja de estar disponible, es posible que se encuentren con un timeout la próxima vez que interactúen con el juego. En el caso de los operadores que utilizan nuestra plataforma completa, podemos avisar de forma proactiva a los jugadores y devolverlos de forma segura al lobby del casino. Cuando los operadores utilizan su propia plataforma junto con nuestro agregador, la forma en que se presentan estas situaciones a los jugadores depende de la plataforma que hayan construido en torno a la integración.
La automatización también debe aplicarse con cuidado. Una breve interrupción de la red no significa necesariamente que un proveedor haya fallado. Por eso, los operadores pueden elegir entre respuestas totalmente automatizadas o una supervisión basada en alertas con intervención manual. Ambos enfoques tienen sus ventajas, y la elección adecuada depende de las preferencias operativas de cada operador y de su grado de apertura a la automatización.
P: ¿Qué pruebas se realizan antes de que un nuevo proveedor entre en producción y por qué continúan mucho tiempo después?
Lo importante no es simplemente probar una integración una vez para que un proveedor pueda entrar en producción. La certificación inicial es imprescindible, pero solo confirma que todo funciona correctamente en ese momento concreto. No garantiza que la integración vaya a seguir comportándose como se espera meses después.
Cada proveedor lleva a cabo su propio proceso de certificación antes de permitirnos ofrecer sus juegos. Eso nos da la aprobación para lanzar la integración, pero es solo la primera fase. Las plataformas evolucionan, los proveedores incorporan nuevas funcionalidades, se implementan mejoras de seguridad y las API cambian con el tiempo. Cualquiera de esos cambios puede afectar de forma involuntaria a una integración existente.
Nos hemos encontrado con casos en los que los proveedores introdujeron cambios para corregir problemas de seguridad o añadir nuevas funcionalidades sin comunicar antes esas actualizaciones. Incluso cambios relativamente pequeños pueden tener consecuencias imprevistas si no se detectan con rapidez.
Por eso hemos implantado un sistema de pruebas automatizadas específico para cada proveedor que integramos. En lugar de confiar únicamente en la certificación original, probamos nuestras integraciones de forma continua con baterías de pruebas exhaustivas adaptadas a cada proveedor. Así podemos identificar cambios inesperados en una fase temprana y resolverlos antes de que se conviertan en incidencias operativas para nuestros clientes.
En definitiva, la certificación permite que una integración entre en producción. Las pruebas continuas son las que ayudan a que siga siendo fiable durante toda su vida útil.
P: Los operadores suelen encontrar garantías de disponibilidad en los acuerdos de servicio. ¿Qué trabajo de ingeniería hay realmente detrás de esas promesas?
Las garantías comerciales y los acuerdos de nivel de servicio no existen de forma aislada. Se basan en las decisiones de ingeniería que determinan cómo se comporta una plataforma cuando, inevitablemente, algo falla.
Desde nuestro punto de vista, los incidentes y los fallos nunca pueden eliminarse por completo. El objetivo no es dar por hecho que nunca ocurrirán, sino diseñar una plataforma que siga funcionando a pesar de ellos. Esa filosofía influye en todos los aspectos de la arquitectura de la plataforma.
La redundancia garantiza que no exista un punto único de fallo, mientras que un failover inteligente permite que los servicios sigan funcionando si algún componente deja de estar disponible. Una supervisión sólida ayuda a detectar los problemas a tiempo, y el gating de funcionalidades o de servicios de terceros permite aislar las partes afectadas de la plataforma sin alterar innecesariamente el resto del sistema.
En conjunto, estas protecciones forman parte de una estrategia de contingencia más amplia. En lugar de permitir que un único incidente afecte a toda la plataforma, el objetivo es contener el problema, mantener el funcionamiento normal siempre que sea posible y restablecer los servicios afectados de forma segura.
En definitiva, la confianza para ofrecer garantías de disponibilidad significativas nace de construir sistemas preparados para los fallos, no de dar por hecho que nunca se producirán. Cuantos más escenarios pueda gestionar una plataforma sin una degradación significativa, más sólidos serán los compromisos de servicio que podrá asumir de forma realista con los operadores.
Cómo elegir una plataforma: Las preguntas que la mayoría de los operadores nunca se plantean
La mayoría de las evaluaciones de plataformas se centran en las funcionalidades visibles, la cartera de juegos y las condiciones comerciales. Sin embargo, muchas de las decisiones que determinan la fiabilidad a largo plazo se encuentran a un nivel mucho más profundo de la propia plataforma. Para terminar, preguntamos a operadores experimentados qué deberían tener en cuenta antes de comprometerse con un socio tecnológico.
P: Si un operador compara hoy plataformas de casino, ¿qué preguntas técnicas debería plantear que la mayoría pasa por alto por completo?
Yo empezaría por dos preguntas. En primer lugar, pregunte si la plataforma puede proporcionar datos en tiempo real que reflejen con precisión el estado actual del sistema. En segundo lugar, pregunte si esos datos están totalmente documentados y si se pueden reproducir. Estas dos capacidades revelan mucho sobre cómo se ha diseñado la plataforma.
La visibilidad en tiempo real da a los operadores la confianza de poder entender lo que ocurre en la plataforma a medida que se desarrollan los acontecimientos, en lugar de esperar a que los problemas salgan a la luz a través de las quejas de los clientes o de interrupciones operativas. Igual de importante es la posibilidad de reproducir los datos. Si cada evento relevante puede reconstruirse, investigarse y auditarse a posteriori, los problemas pueden resolverse a partir de evidencias y no de suposiciones.
En muchos sentidos, estas capacidades distinguen una plataforma que realmente se puede operar y mantener de otra que simplemente funciona cuando todo va bien. Una plataforma nunca debería ser una caja negra. Los operadores deberían poder entender qué hace, por qué lo hace y qué ocurre si sucede algo inesperado.
Las funcionalidades, la cartera de juegos y las condiciones comerciales siempre serán importantes, pero son solo una parte de la evaluación. En última instancia, la ingeniería que hay bajo la superficie determina hasta qué punto una plataforma será predecible, transparente y fiable a largo plazo.
Las plataformas de casino más sólidas hacen que una ingeniería compleja parezca sencilla.