Por dentro das integrações de plataformas de cassino: A engenharia que mantém os operadores online
Atualizado 2 out. 2026•Publicado 2 out. 2026
Principais conclusões
- Cada lançamento de jogo esconde toda uma cadeia: a plataforma autentica o jogador, protege a sessão e troca validações com o provedor — tudo em questão de segundos.
- As plataformas turnkey carregam anos de engenharia: os operadores herdam arquitetura, segurança, compliance e integrações com bem mais de cem provedores, cada um com sua própria API.
- APIs ruins causam danos reais: integrações frágeis expõem vulnerabilidades de segurança, derrubam sessões, dessincronizam saldos e minam a confiança dos jogadores.
- A arquitetura isola as falhas dos provedores: uma plataforma bem projetada funciona como uma camada de proteção e contém o problema de um provedor antes que ele se espalhe pelo sistema.
- A telemetria identifica problemas em segundos: chamadas que excedem de forma consistente ~200 milissegundos sinalizam um provedor em degradação, que a plataforma pode desativar automaticamente.
- A certificação é só o começo: suítes de testes automatizados contínuos detectam mudanças não anunciadas dos provedores antes que se tornem problemas operacionais.
- Pergunte sobre dados em tempo real e sobre a possibilidade de reproduzi-los: essas duas capacidades, muitas vezes ignoradas, revelam se uma plataforma pode realmente ser operada — ou se é uma caixa-preta.
Toda vez que um jogador abre um jogo de cassino, uma complexa sequência de eventos acontece em segundo plano. Vários sistemas autenticam o jogador, estabelecem sessões seguras, trocam dados com provedores de jogos externos e mantêm saldos, apostas e ganhos sincronizados. E tudo isso acontece em questão de segundos.
Para os operadores, grande parte dessa engenharia permanece invisível até que algo dê errado. Um provedor lento, uma API instável ou uma queda inesperada, por exemplo, já bastam para gerar um problema comercial que pode afetar rapidamente a confiança dos jogadores e a receita.
Construir a arquitetura que mantém esses riscos sob controle exige anos de experiência em engenharia. De integrações estáveis e sistemas de failover a testes rigorosos, grande parte do valor de uma plataforma está em evitar que os operadores enfrentem problemas.
Conversamos com Ioannis Loukeris, da equipe de desenvolvimento da Agreegain, sobre a disciplina de engenharia por trás das plataformas de cassino modernas, a importância de integrações resilientes e o que os operadores devem entender antes de escolher um parceiro de tecnologia.
O que realmente acontece por trás de cada lançamento de jogo?
Do ponto de vista do jogador, abrir um jogo de cassino costuma ser instantâneo. Nos bastidores, porém, dezenas de processos técnicos trabalham em conjunto para autenticar os usuários, estabelecer conexões seguras e sincronizar informações entre vários sistemas. Entender essa complexidade oculta ajuda a explicar por que é tão difícil replicar uma engenharia de plataformas experiente.
P: Para um operador que nunca viu os bastidores, o que acontece tecnicamente quando um jogador abre um jogo de cassino?
A maioria dos jogadores clica em “Jogar” e espera que o jogo carregue quase instantaneamente. Por trás desse simples clique, porém, ocorre uma sequência de comunicação cuidadosamente orquestrada entre a plataforma de cassino e o provedor do jogo.
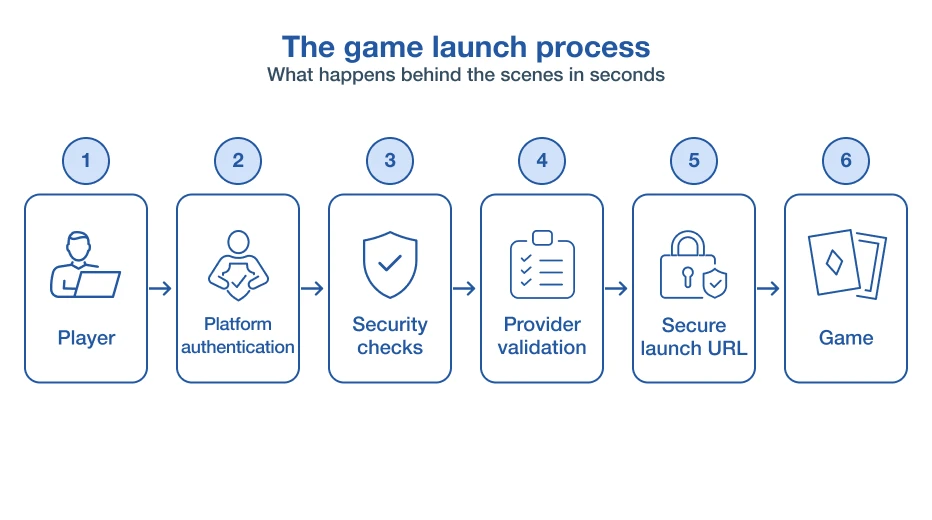
O processo começa quando o front-end solicita à plataforma uma URL de lançamento do jogo. Antes mesmo de essa solicitação chegar ao provedor, a plataforma autentica o jogador, realiza as verificações de segurança necessárias e estabelece uma sessão segura. Em seguida, o provedor faz sua própria validação, confirma que está tudo em ordem e se comunica com a plataforma para preparar a sessão de jogo. Somente depois de concluídas essas verificações, o provedor gera uma URL segura de lançamento do jogo e a devolve à plataforma, que por sua vez a repassa ao navegador do jogador para que o jogo finalmente carregue.
Embora toda essa troca normalmente leve apenas alguns segundos, cada etapa precisa funcionar perfeitamente. O jogador espera uma experiência rápida e fluida, mas, nos bastidores, a plataforma está continuamente verificando identidades, protegendo dados, sincronizando informações e garantindo a comunicação segura entre vários sistemas independentes. Se qualquer parte dessa cadeia falhar, o jogo pode não ser iniciado corretamente.
É por isso que construir uma plataforma de cassino moderna vai muito além de simplesmente conectar jogos de diferentes provedores. O desafio de engenharia está em fazer um processo extremamente complexo parecer simples e, ao mesmo tempo, garantir que cada interação continue segura, precisa e confiável, muito antes de o jogador fazer sua primeira aposta.
P: Quando um operador escolhe uma plataforma turnkey ou um agregador, que trabalho de engenharia ele está realmente herdando?
Uma plataforma turnkey de qualidade representa anos de engenharia, aprimoramento e experiência operacional real. Não é apenas um conjunto de funcionalidades reunidas em uma única interface. Por trás dela estão a arquitetura, a segurança, o compliance, as integrações e o conhecimento operacional necessários para sustentar um negócio de iGaming moderno.
Essa tarefa ficou ainda maior com a evolução da regulamentação. Hoje, as plataformas precisam operar em várias jurisdições, integrar-se a uma ampla variedade de serviços de terceiros, proteger dados sensíveis e se manter confiáveis sob demanda contínua. Construir tudo isso do zero exige um investimento significativo de tempo, conhecimento e recursos. Mesmo uma plataforma projetada para um único operador em um único mercado é um empreendimento considerável.
O mesmo princípio se aplica à agregação de jogos. Existem bem mais de cem provedores de jogos no mercado, cada um com sua própria API, seus próprios requisitos técnicos e sua própria forma de lidar com sessões de jogo, transações e atualizações. Manter essas integrações atualizadas e sincronizadas é, por si só, um trabalho contínuo de engenharia.
Um agregador elimina grande parte dessa complexidade ao oferecer aos operadores uma integração única e estável. Em vez de manter dezenas de conexões individuais com provedores e se adaptar por conta própria a cada mudança técnica, os operadores se integram uma única vez e deixam que o agregador cuide da manutenção contínua nos bastidores. Isso permite que os operadores concentrem seus próprios recursos de desenvolvimento nas áreas que diferenciam o negócio, em vez de dedicá-los continuamente à manutenção das integrações com provedores.
Como uma boa engenharia protege os operadores contra riscos técnicos
Problemas técnicos não continuam sendo apenas técnicos por muito tempo. Provedores lentos, integrações instáveis ou APIs mal projetadas acabam resultando em sessões interrompidas, jogadores frustrados e perda de receita. As perguntas a seguir mostram como uma arquitetura de plataforma resiliente evita esses problemas antes que eles afetem o negócio do operador.
P: Muita gente ouve falar do termo “API”, mas como é, na prática, uma integração mal projetada?
Uma API bem projetada é algo que os jogadores nunca deveriam perceber. Quando ela funciona corretamente, as sessões de jogo começam sem problemas, os saldos permanecem precisos, as apostas são processadas corretamente e os ganhos são creditados sem atraso. Os problemas só aparecem quando isso começa a falhar.
Um dos riscos mais graves é a segurança. Como qualquer sistema responsável por movimentar dinheiro e lidar com dados sensíveis dos jogadores, as APIs dos provedores de jogos estão constantemente expostas a tentativas de ataque. Se essas interfaces não forem projetadas e mantidas com um alto padrão de qualidade, podem criar vulnerabilidades desnecessárias que colocam em risco tanto os operadores quanto os jogadores.
A estabilidade é igualmente importante. Uma integração pouco confiável pode fazer com que as sessões de jogo caiam inesperadamente, atrasar a confirmação de apostas ou ganhos, ou deixar os saldos temporariamente dessincronizados. Mesmo depois de resolvido o problema de origem, o jogador continua sentindo insegurança. Se ele não consegue ver seus ganhos imediatamente ou concluir uma sessão como esperava, a confiança na plataforma começa a diminuir.
A documentação também tem um papel maior do que muita gente imagina. APIs mal documentadas ou inconsistentes obrigam os desenvolvedores a criar soluções paliativas apenas para que sistemas diferentes consigam se comunicar. Essas soluções paliativas acrescentam complexidade desnecessária e se tornam pontos de falha adicionais à medida que as plataformas evoluem.
Em última análise, a qualidade de uma integração se mede pelo pouco que os jogadores a percebem. A melhor engenharia é invisível e permite que cada jogo, transação e atualização de saldo ocorra de forma consistente, segura e sem interrupções.
P: Como vocês evitam que os problemas técnicos de um provedor se tornem um problema do operador?
O objetivo é garantir que um problema que afeta um provedor continue sendo exatamente isso — um problema do provedor — e não algo que prejudique toda a plataforma do operador.
Isso começa pela arquitetura da plataforma. Uma plataforma ou um agregador bem projetado funciona como uma camada de proteção entre o operador e os muitos serviços de terceiros dos quais ele depende. Em vez de expor o operador diretamente aos diferentes comportamentos e particularidades técnicas de cada provedor, a plataforma padroniza essas interações por meio de uma interface consistente e monitora continuamente o desempenho de cada provedor.
Se algo inesperado acontecer, seja um erro, um comportamento instável ou a indisponibilidade de um provedor, a plataforma deve ser capaz de isolar o problema antes que ele se espalhe. Isso significa impedir que um serviço com falha afete partes não relacionadas da plataforma ou cause uma interrupção mais ampla para os jogadores.
O mesmo princípio vale para a segurança. Ao controlar como as informações trafegam entre o operador e os provedores externos, a plataforma reduz a exposição desnecessária e ajuda a filtrar problemas antes que cheguem ao restante do sistema.
Em última análise, resiliência não significa presumir que os problemas nunca vão acontecer. Em uma plataforma conectada a dezenas de provedores externos, problemas ocasionais são inevitáveis. Boa engenharia significa conter esses problemas rapidamente, para que o restante da plataforma continue operando normalmente enquanto o serviço afetado é investigado e o problema é resolvido.
P: À medida que os operadores continuam adicionando provedores e milhares de novos jogos, como vocês mantêm um desempenho consistente da plataforma?
A arquitetura do sistema tem o papel mais importante na escalabilidade. Adicionar mais provedores e jogos não é simplesmente aumentar a quantidade de conteúdo disponível para os jogadores. Cada nova integração traz mais comunicação, processamento de dados e interações entre sistemas, que a plataforma precisa gerenciar com eficiência.
Uma arquitetura bem projetada usa tecnologias modernas e topologias cuidadosamente planejadas para escalar conforme a demanda cresce. O ideal é que o desempenho aumente de forma previsível, quase linear, à medida que novos recursos são adicionados, em vez de se tornar cada vez mais difícil de gerenciar.
Também existe o equívoco comum de que adotar uma arquitetura orientada a serviços ou distribuída resolve automaticamente a escalabilidade. Na prática, essa é apenas parte da solução. A forma como os serviços se comunicam entre si e as responsabilidades atribuídas a cada um são igualmente importantes. Um design ruim nesse nível pode criar problemas desnecessários, por mais moderna que seja a tecnologia subjacente.
Em última análise, toda plataforma chega a um ponto em que o banco de dados se torna um dos desafios de engenharia mais importantes. À medida que mais provedores, jogadores e transações são adicionados, manter o desempenho depende de decisões de arquitetura cuidadosas em toda a plataforma, e não apenas de adicionar mais hardware. É aí que uma engenharia bem pensada se torna essencial para garantir que os operadores possam continuar ampliando seu conteúdo sem comprometer a experiência do jogador.
P: Você pode descrever um desafio de integração especialmente difícil que sua equipe resolveu e o que os operadores teriam enfrentado se ele não tivesse sido resolvido?
Um dos desafios técnicos mais exigentes que enfrentamos foi a enorme variedade de formas como os diferentes provedores de jogos operam. Vistos de fora, todos podem parecer oferecer a mesma coisa: um catálogo de jogos de cassino. Mas, nos bastidores, a lógica de funcionamento, os métodos de comunicação e os requisitos técnicos de cada um podem variar bastante.
Nosso objetivo era unificar todas essas abordagens diferentes por trás de uma única API consistente. No início, alguns provedores eram tão diferentes que isso parecia quase impossível. Foram necessários planejamento cuidadoso, pesquisa extensa e muita análise para entender onde estavam essas diferenças e como superá-las sem comprometer a confiabilidade.
Em alguns casos, também tivemos que compensar problemas nas próprias implementações dos provedores, resolvendo-os dentro do nosso sistema para que os operadores pudessem interagir com todos os provedores exatamente da mesma forma.
Se não tivéssemos resolvido esses desafios, alguns provedores simplesmente não poderiam ser oferecidos pelo agregador. Mais importante ainda, os operadores teriam que lidar com um comportamento inconsistente entre provedores, com apostas, ganhos e sessões de jogo tratados de forma diferente dependendo do estúdio que o jogador estivesse usando. Isso anularia, em grande parte, o próprio propósito de usar um agregador.
O objetivo nunca foi simplesmente conectar mais provedores. Era garantir que, independentemente de quem desenvolveu o jogo, os operadores pudessem contar com uma integração única e consistente, com comportamento previsível em toda a plataforma.
Como manter milhares de integrações funcionando com confiabilidade
Criar integrações é apenas parte do desafio. Manter centenas de conexões com provedores funcionando de forma confiável ao longo de meses e anos exige monitoramento e testes contínuos, além de disciplina operacional. É aqui que se gera grande parte do valor de longo prazo de uma plataforma, embora operadores e jogadores raramente vejam a engenharia envolvida.
P: Como uma única integração com um agregador reduz o risco técnico em comparação com a manutenção de dezenas de integrações diretas com provedores?
O valor de um agregador está em oferecer aos operadores uma API única e estável, que não muda ou que só muda de forma retrocompatível. Depois que essa integração é implementada e validada, os operadores podem continuar operando seus próprios sistemas sem precisar se adaptar constantemente às mudanças introduzidas por cada provedor de jogos.
Nos bastidores, porém, esses provedores continuam evoluindo. Eles lançam novas funcionalidades, atualizam suas APIs, reforçam a segurança ou, ocasionalmente, fazem até mudanças que exigem um esforço de engenharia significativo para serem suportadas. Em alguns casos, essas mudanças podem nem ser retrocompatíveis.
Em vez de cada operador ter que monitorar, implementar e testar essas mudanças por conta própria, o agregador assume essa responsabilidade. Ele atualiza cada integração com os provedores, mantém a compatibilidade e garante que a plataforma continue oferecendo aos operadores a mesma interface estável com a qual se integraram originalmente.
Para os operadores que mantêm conexões diretas, essa responsabilidade nunca desaparece. Cada relação com um provedor se torna mais uma integração para monitorar, manter e sincronizar ao longo do tempo. À medida que o número de provedores cresce, aumenta também o esforço de engenharia necessário apenas para manter tudo funcionando de forma confiável.
Em última análise, o papel de um agregador não é apenas simplificar a integração inicial. É assumir o trabalho contínuo de engenharia necessário para manter dezenas de conexões com provedores, permitindo que os operadores concentrem seus próprios recursos de desenvolvimento em construir e aprimorar sua plataforma, em vez de dedicá-los continuamente à manutenção de integrações de terceiros.
P: Quando algo dá errado, com que rapidez a plataforma consegue detectar o problema e reagir antes que os jogadores sejam afetados?
Com a telemetria, conseguimos detectar possíveis problemas quase instantaneamente. Monitoramos cada interação com um provedor; assim, se os tempos de resposta começam a aumentar, conseguimos identificar um comportamento incomum em segundos. Por exemplo, se chamadas individuais excedem de forma consistente cerca de 200 milissegundos, isso pode ser tratado como suspeito. Quando se acumulam eventos suficientes desse tipo, normalmente é possível confirmar que o serviço do provedor está se degradando, e não passando por um atraso temporário.
Depois de identificado o problema, a resposta depende das preferências do operador. A plataforma pode isolar automaticamente o provedor afetado, desativando-o e removendo seus jogos do lobby, o que impede que novos jogadores entrem em sessões instáveis.
Os jogadores que já estão em um jogo naturalmente exigem um tratamento diferente. Se um provedor ficou indisponível, eles podem receber um timeout na próxima vez que interagirem com o jogo. Para os operadores que usam nossa plataforma completa, podemos notificar os jogadores de forma proativa e levá-los de volta com segurança ao lobby do cassino. Quando os operadores usam sua própria plataforma junto com nosso agregador, a forma como essas situações são apresentadas aos jogadores depende da plataforma que eles construíram em torno da integração.
A automação também precisa ser aplicada com cuidado. Uma breve interrupção de rede não significa necessariamente que um provedor falhou. Por isso, os operadores podem escolher entre respostas totalmente automatizadas ou um monitoramento baseado em alertas com intervenção manual. As duas abordagens têm suas vantagens, e a escolha adequada depende das preferências operacionais de cada operador e de sua disposição para a automação.
P: Que testes são realizados antes de um novo provedor entrar no ar e por que os testes continuam por muito tempo depois?
O importante não é simplesmente testar uma integração uma única vez para que um provedor possa entrar no ar. A certificação inicial é essencial, mas apenas confirma que tudo está funcionando corretamente naquele momento específico. Ela não garante que a integração continuará se comportando como esperado meses depois.
Cada provedor realiza seu próprio processo de certificação antes de nos permitir oferecer seus jogos. Isso nos dá a aprovação para lançar a integração, mas é apenas a primeira etapa. As plataformas evoluem, os provedores lançam novas funcionalidades, melhorias de segurança são implementadas e as APIs mudam com o tempo. Qualquer uma dessas mudanças pode afetar, sem querer, uma integração existente.
Já passamos por situações em que provedores fizeram mudanças para corrigir problemas de segurança ou introduzir novas funcionalidades sem comunicar essas atualizações com antecedência. Mesmo mudanças relativamente pequenas podem ter consequências inesperadas se não forem detectadas rapidamente.
Por isso, criamos um sistema dedicado de testes automatizados para cada provedor que integramos. Em vez de depender apenas da certificação original, testamos continuamente nossas integrações com suítes de testes abrangentes, adaptadas a cada provedor. Isso nos permite identificar mudanças inesperadas logo no início e resolvê-las antes que se tornem problemas operacionais para nossos clientes.
Em última análise, a certificação permite que uma integração entre no ar. São os testes contínuos que ajudam a mantê-la confiável durante toda a sua vida útil.
P: Os operadores costumam ver garantias de disponibilidade nos contratos de serviço. Que trabalho de engenharia existe de fato por trás dessas promessas?
Garantias comerciais e acordos de nível de serviço não existem isoladamente. Eles se baseiam nas decisões de engenharia que determinam como uma plataforma se comporta quando, inevitavelmente, algo dá errado.
Do nosso ponto de vista, incidentes e falhas nunca podem ser totalmente eliminados. O objetivo não é presumir que eles nunca vão acontecer, mas projetar uma plataforma que continue operando apesar deles. Essa filosofia influencia todos os aspectos da arquitetura da plataforma.
A redundância garante que não exista um ponto único de falha, enquanto um failover inteligente permite que os serviços continuem operando se componentes individuais ficarem indisponíveis. Um monitoramento robusto ajuda a detectar problemas cedo, e o gating de funcionalidades ou de serviços de terceiros permite isolar as partes afetadas da plataforma sem prejudicar desnecessariamente o restante do sistema.
Em conjunto, essas proteções fazem parte de uma estratégia de contingência mais ampla. Em vez de permitir que um único incidente afete toda a plataforma, o objetivo é conter o problema, manter a operação normal sempre que possível e restaurar os serviços afetados com segurança.
Em última análise, a confiança para oferecer garantias de disponibilidade relevantes vem da construção de sistemas preparados para falhas, e não da suposição de que as falhas nunca vão ocorrer. Quanto mais cenários uma plataforma conseguir gerenciar sem uma degradação significativa, mais sólidos serão os compromissos de serviço que ela poderá assumir, de forma realista, com os operadores.
Como escolher uma plataforma: As perguntas que a maioria dos operadores nunca faz
A maioria das avaliações de plataformas se concentra em funcionalidades visíveis, portfólios de jogos e condições comerciais. No entanto, muitas das decisões que determinam a confiabilidade de longo prazo estão em camadas muito mais profundas da própria plataforma. Para encerrar, perguntamos a operadores experientes o que eles deveriam observar antes de se comprometer com um parceiro de tecnologia.
P: Se um operador estiver comparando plataformas de cassino hoje, que perguntas técnicas ele deveria fazer e que a maioria das pessoas ignora completamente?
Eu começaria com duas perguntas. Primeiro, pergunte se a plataforma consegue fornecer dados em tempo real que reflitam com precisão o estado atual do sistema. Segundo, pergunte se esses dados são totalmente documentados e se podem ser reproduzidos. Essas duas capacidades revelam muito sobre como a plataforma foi projetada.
A visibilidade em tempo real dá aos operadores a confiança de que conseguem entender o que está acontecendo na plataforma à medida que os eventos se desenrolam, em vez de esperar que os problemas apareçam por meio de reclamações de clientes ou interrupções operacionais. A possibilidade de reproduzir os dados é igualmente importante. Se cada evento relevante puder ser reconstruído, investigado e auditado posteriormente, os problemas podem ser resolvidos com base em evidências, e não em suposições.
De muitas formas, essas capacidades separam uma plataforma que pode realmente ser operada e suportada de outra que simplesmente funciona quando tudo vai bem. Uma plataforma nunca deveria ser uma caixa-preta. Os operadores devem ser capazes de entender o que ela está fazendo, por que está fazendo isso e o que acontece se algo inesperado ocorrer.
Funcionalidades, portfólios de jogos e condições comerciais sempre serão importantes, mas são apenas parte da avaliação. Em última análise, é a engenharia por baixo da superfície que determina o quão previsível, transparente e confiável uma plataforma será no longo prazo.
As plataformas de cassino mais sólidas fazem a engenharia complexa parecer simples.